L’intelligenza artificiale viene usata sempre più spesso per produrre riassunti e report di contenuti complessi. Il vantaggio è evidente. In pochi secondi si può ottenere una sintesi di informazioni che richiederebbero molto più tempo per essere esaminate. Ma cosa succede se il risultato contiene un dettaglio sbagliato?
È la domanda da cui parte uno studio condotto da Georgetown University e University of Washington. Gli autori hanno analizzato non soltanto gli errori prodotti dai modelli, ma anche il possibile effetto che un’informazione fuorviante può avere sulla memoria umana. Il punto, dunque, non è soltanto capire quanto sia affidabile il risultato prodotto, ma anche se eventuali imprecisioni possano incidere su chi lo legge.
Come è stato condotto lo studio sui riassunti generati dall’AI
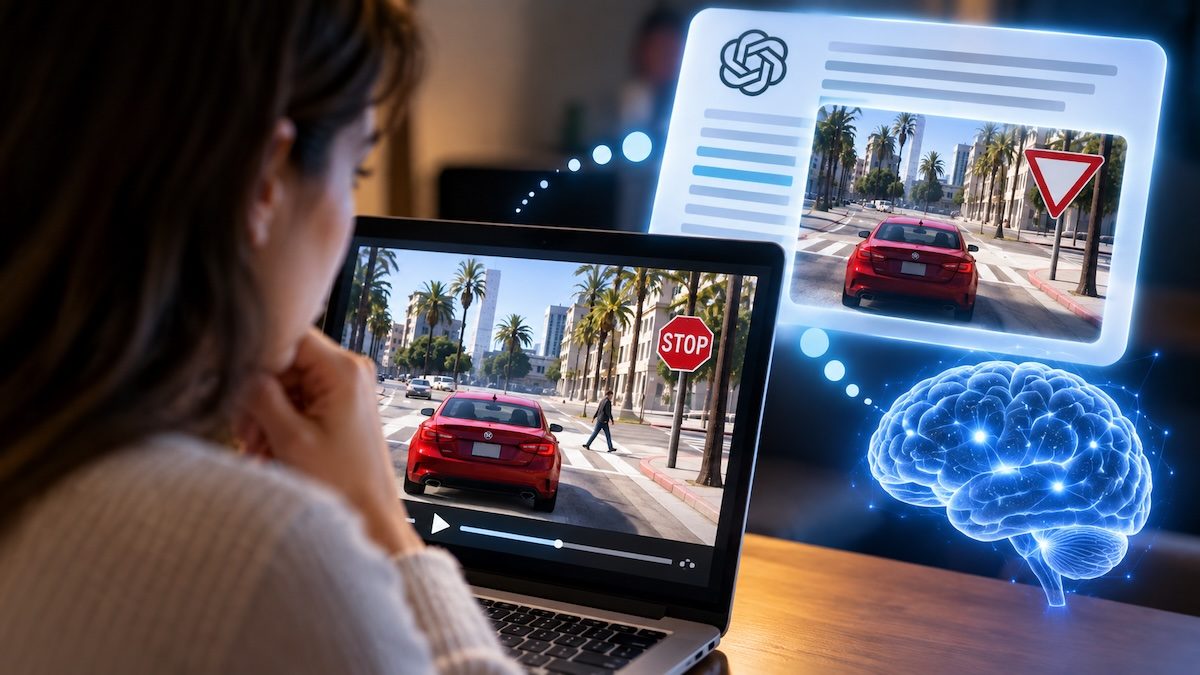
Lo studio ha seguito due passaggi. Nel primo, i ricercatori hanno messo alla prova ChatGPT-5.5 e Gemini 2.5 Flash-Lite, affidando ai due modelli il compito di riassumere due brevi video animati, entrambi della durata di 25 secondi. Le scene, realizzate all’interno di Grand Theft Auto V e già utilizzate in precedenti studi sulla memoria, mostravano un’auto rossa che raggiungeva un incrocio, svoltava e investiva un pedone.
I filmati erano quasi identici, ma presentavano una differenza centrale. In uno compariva un segnale di STOP, nell’altro un segnale di dare precedenza. Ogni modello ha ricevuto ciascun video cinque volte, sempre in una nuova sessione, producendo complessivamente 20 riassunti.
Il prompt, cioè l’istruzione fornita ai modelli, era stato formulato proprio per ridurre il rischio di imprecisioni. Ai sistemi veniva chiesto di produrre almeno 300 parole, mantenere un tono neutrale e fattuale, non introdurre interpretazioni o elementi nuovi e includere tutti gli avvenimenti importanti. Nonostante queste indicazioni, tutti e 20 i testi contenevano errori, da un minimo di 7 a un massimo di 21 per testo.
Le omissioni erano la categoria più frequente. Gli studiosi avevano individuato 19 dettagli centrali delle scene e, in media, i modelli ne hanno tralasciato il 51,6%. Ancora più sorprendente è che 19 testi su 20 non menzionavano l’evento principale, ovvero l’auto che investiva il pedone, un dato questo corrispondente al 95%. In altri casi comparivano informazioni inesatte, aggiunte non presenti nel video o vere e proprie “allucinazioni” dell’AI, come veicoli o persone che nella sequenza originale non esistevano.
Questa prima analisi serviva soprattutto a individuare quali problemi potessero emergere. Per verificare se queste imprecisioni avessero conseguenze anche sui lettori, gli autori hanno quindi organizzato un secondo esperimento.
Un dettaglio sbagliato può modificare i nostri ricordi
Al secondo esperimento hanno partecipato adulti statunitensi reclutati online. In 331 hanno completato entrambe le sessioni e, dopo l’esclusione di tre individui che non avevano superato un controllo dell’attenzione, 328 partecipanti sono stati inclusi nelle analisi. Ognuno guardava uno dei due video e doveva prestare attenzione a ciò che accadeva. Dopo 24-48 ore tornava per la fase successiva e leggeva una sintesi di 21 frasi generata con ChatGPT.
Il passaggio decisivo riguardava il segnale stradale. A seconda del gruppo, il testo riportava correttamente quello visto nel filmato o lo sostituiva con l’altro. Chi aveva osservato uno STOP poteva pertanto leggere che l’auto era arrivata a un segnale di dare precedenza e viceversa. Il resto della sintesi rimaneva sostanzialmente uguale, così da isolare l’effetto di quel singolo particolare.
Subito dopo, ai volontari veniva chiesto di rispondere a una serie di domande basandosi sul video originale, non sul testo appena letto. Tra queste, una chiedeva quale segnale fosse presente all’incrocio.
La differenza è stata netta. Tra chi aveva letto una sintesi coerente con il filmato, l’83,6% ha ricordato il cartello corretto. Nel gruppo esposto all’informazione fuorviante, invece, la percentuale è scesa al 44,8%. Gli altri quesiti indicano che i volontari non avevano semplicemente dimenticato tutta la scena. Per esempio, il 96,6% ricordava che l’incidente era avvenuto di giorno e, in media, i partecipanti hanno fornito la risposta giusta al 91,4% delle 11 domande non centrali.
C’è poi un altro elemento interessante. Prima della lettura, ad alcuni partecipanti veniva detto che la sintesi era stata prodotta da un sistema AI, ad altri che proveniva da un trascrittore umano. In realtà il contenuto era sempre generato con ChatGPT. Sapere, o credere, che dietro il testo ci fosse l’intelligenza artificiale non ha ridotto in modo significativo l’effetto dell’informazione sbagliata. Nemmeno il livello dichiarato di fiducia nei sistemi AI o la frequenza con cui venivano utilizzati sembravano incidere sul risultato.
Perché un’informazione fuorviante può interferire con la memoria e quali sono i limiti della ricerca
Il fenomeno non nasce con l’intelligenza artificiale. In psicologia è noto da decenni come misinformation effect. Dopo aver vissuto o osservato un evento, l’esposizione successiva a informazioni inesatte può modificare il modo in cui alcuni dettagli vengono ricordati. La memoria, infatti, non funziona come una registrazione immutabile, ma è il risultato di un processo ricostruttivo, influenzato anche da ciò che apprendiamo in seguito.
La ricerca applica questo meccanismo ai testi prodotti dai modelli generativi. Il punto più delicato è che l’errore non deve necessariamente essere plateale. Un particolare apparentemente piccolo, come uno STOP trasformato in un dare precedenza, può essere sufficiente per interferire con il ricordo. Ed è proprio questo che rende il tema rilevante quando le sintesi automatiche vengono usate in contesti nei quali l’accuratezza conta molto.
Gli autori citano, per esempio, l’impiego dell’AI per generare rapporti o riassunti in ambito di polizia. In questi casi si tende spesso a pensare che la presenza di una persona incaricata di verificare il testo generato, il cosiddetto human in the loop, possa correggere eventuali errori. Lo studio suggerisce però un possibile problema. La stessa persona chiamata a controllare il testo potrebbe essere influenzata dalle informazioni inesatte che sta leggendo.
Questo non significa, però, che sia stato dimostrato che ogni riassunto AI alteri la memoria o che gli stessi risultati si verifichino automaticamente in situazioni reali. L’esperimento era molto controllato, riguardava due semplici video animati e ha testato direttamente l’effetto di un solo tipo di informazione falsa, cioè il segnale stradale. Anche l’analisi degli errori dei modelli era circoscritta a un unico prompt e 20 testi generati.
Il risultato mette in evidenza un rischio concreto: un errore in una sintesi automatica può condizionare il modo in cui una persona ricostruisce ciò che aveva visto. Gli stessi autori sottolineano, però, la necessità di verificare il fenomeno con materiali più realistici e in scenari diversi.